
Claude Code 에이전트 설계: 지침부터 검증 루프까지
Claude Code에 일을 맡길 때는 프로젝트 규칙, 반복 절차, 검사 시점, 조사 범위를 나눠 설계하면 됩니다. CLAUDE.md에는 계속 참고할 규칙을, Skill에는 재사용할 절차를 담습니다. Hook은 정해진 시점에 검사를 실행하고, Subagent는 별도 대화 맥락에서 한정된 일을 수행합니다. 어떤 기능을 추가할지는 실제로 반복되는 실수와 누락을 보고 결정할 수 있습니다.
이 글은 Lydia Hallie의 Claude Code 강좌 내용을 요약하고, 실무 적용 방법을 덧붙였습니다. 원 강좌 공개일은 2026년 5월 20일, 공식 문서 대조일은 2026년 9월 19일입니다. 강좌의 기본 개념은 계속 유용하지만, 일부 명령과 기본 설정은 현재 레퍼런스와 다릅니다. 아래에 변경 사항과 설명을 보완할 부분을 구분했습니다.
원본 강좌와 공유된 영상
원본은 Frontend Masters의 후속 사이트인 Master.dev의 무료 Claude Code 강좌입니다. Anthropic에서 Claude Code 개발자 경험과 기술 교육을 맡는 Lydia Hallie가 진행합니다. 원 강좌는 16개 수업, 1시간 56분 54초이며 무료 계정 등록 후 수강할 수 있습니다.
@DAIEvolutionHub가 공유한 게시물과 연결된 아래 영상은 Bharat Tech 채널에 9월 18일 올라온 62분 30초 편집 재게시본입니다. 강좌의 소개, 시연 내용과 원본 수업의 공개 자막을 대조해 출처를 확인했습니다. 9월 업로드 날짜를 강좌의 최초 공개일로 읽으면 시점을 잘못 판단하게 됩니다.
YouTube에서 편집본 보기 · 전체 수업은 공식 원본 강좌에서 확인할 수 있습니다. 게시물의 “500달러 강좌를 대체한다”는 표현은 공유자의 평가이며, 강좌 간 효과를 측정한 결과는 제시되지 않았습니다.
원 강좌는 Claude Code의 내부 작동 방식에서 출발해 CLAUDE.md, 권한, 추론 강도와 컨텍스트, Skills, Hooks, Subagents, Agent teams를 설명합니다. 이어 Plugins와 MCP, Desktop·GitHub 작업 흐름, Cowork, Agent SDK를 소개합니다. ‘자기 개선 루프와 그래프’라는 독립 수업은 원본 목차에 없습니다. 이 글의 해당 부분은 별도의 Anthropic 자료를 참고한 확장 설명으로 표시했습니다.
현재 공식 레퍼런스와 다른 부분
강좌의 Subagents, Skill Creator, CLAUDE.md와 Plan mode, Agent teams 수업을 현재 공식 문서와 대조했습니다. 아래 첫 두 항목은 공식 문서에 변경 버전이 명시돼 있습니다. 나머지는 강좌 설명의 범위와 현재 동작을 비교한 것으로, 모두 5월 이후 새로 바뀌었다고 단정할 수는 없습니다.
| 항목 | 강좌 설명·시연 | 현재 공식 문서 |
|---|---|---|
| Subagent 생성 | /agents에서 생성 마법사 실행 | v2.1.198부터 마법사 제거. Claude에 파일 생성을 요청하거나 직접 작성. 생성 방법 |
| Explore 기본 모델 | Haiku로 코드베이스 탐색 | v2.1.198부터 주 대화 모델 상속. Claude API에서는 Opus 상한 적용. 기본 모델 |
| Skill의 allowed-tools | 기재된 도구만 쓸 수 있다고 설명 | 호출한 턴의 사전 승인 목록. 다른 도구는 기존 권한 규칙 적용. 권한 동작 |
| Plan mode | 코딩하지 말라는 지침을 추가한다고 설명 | 도구 실행을 제어하는 권한 모드도 적용. 소스 파일을 편집하지 않고 조사. 권한 모드 |
| Subagent 간 통신 | 서로 직접 대화할 수 없다고 설명 | 생성 시 이름이 붙은 Subagent는 메시지 교환 가능. 현재 비교표 |
| Agent teams 실행 | 자연어로 팀 구성을 요청하는 흐름 | 실험 기능이며 기본 비활성. 환경 설정과 대화형 세션 필요. 활성화 조건 |
따라 할 때 바로 달라지는 것은 생성 방법과 비용 가정입니다. 현재 Subagent는 프로젝트의 .claude/agents/ 또는 개인 설정의 ~/.claude/agents/에 Markdown 파일로 정의합니다. Explore에 조사를 맡긴다고 항상 Haiku 비용으로 실행되는 것도 아닙니다. 모델을 따로 지정했다면 그 설정까지 확인해야 합니다.
allowed-tools의 승인 효과는 다음 사용자 메시지가 오면 해제됩니다. 목록 밖 도구를 전부 차단하는 설정으로 사용하면 안 됩니다. Skill에서 도구를 제외하는 disallowed-tools와 세션의 권한 규칙을 구분해 적용해야 합니다. “읽기만 해줘”라는 문장과 실제 도구 제한은 각각 확인할 대상입니다.
Plan mode도 실제 모드를 선택해야 합니다. claude --permission-mode plan으로 시작할 수 있으며, 현재 문서는 읽기 전용 명령과 auto mode 사용 시 분류기가 승인한 명령의 실행 조건을 함께 설명합니다. 채팅에 “계획만 세워줘”라고 적는 것만으로 동일한 권한 설정이 적용된다고 가정하지 마세요.
Agent teams는 CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1로 활성화합니다. -p 비대화형 실행과 Agent SDK 세션에서는 팀원을 생성하지 않습니다. 기능을 켜면 이름이 붙은 Subagent가 팀원으로 실행될 수도 있으므로, 일반적인 위임 동작에도 영향을 줍니다. 현재 사용 조건
모델의 판단과 도구 실행을 구분하기
강좌 초반은 모델과 실행 환경의 역할부터 설명합니다. 모델은 주어진 대화와 도구 설명을 보고 다음 행동을 제안합니다. Claude Code는 프로젝트 정보와 대화를 구성해 모델에 보내고, 도구 호출 요청을 받아 권한을 확인한 뒤 실행합니다. 결과가 다시 모델의 입력에 들어가면 다음 판단이 이어집니다. 이런 실행 환경을 강좌에서는 harness라고 부릅니다. 원 강좌: 내부 작동 방식
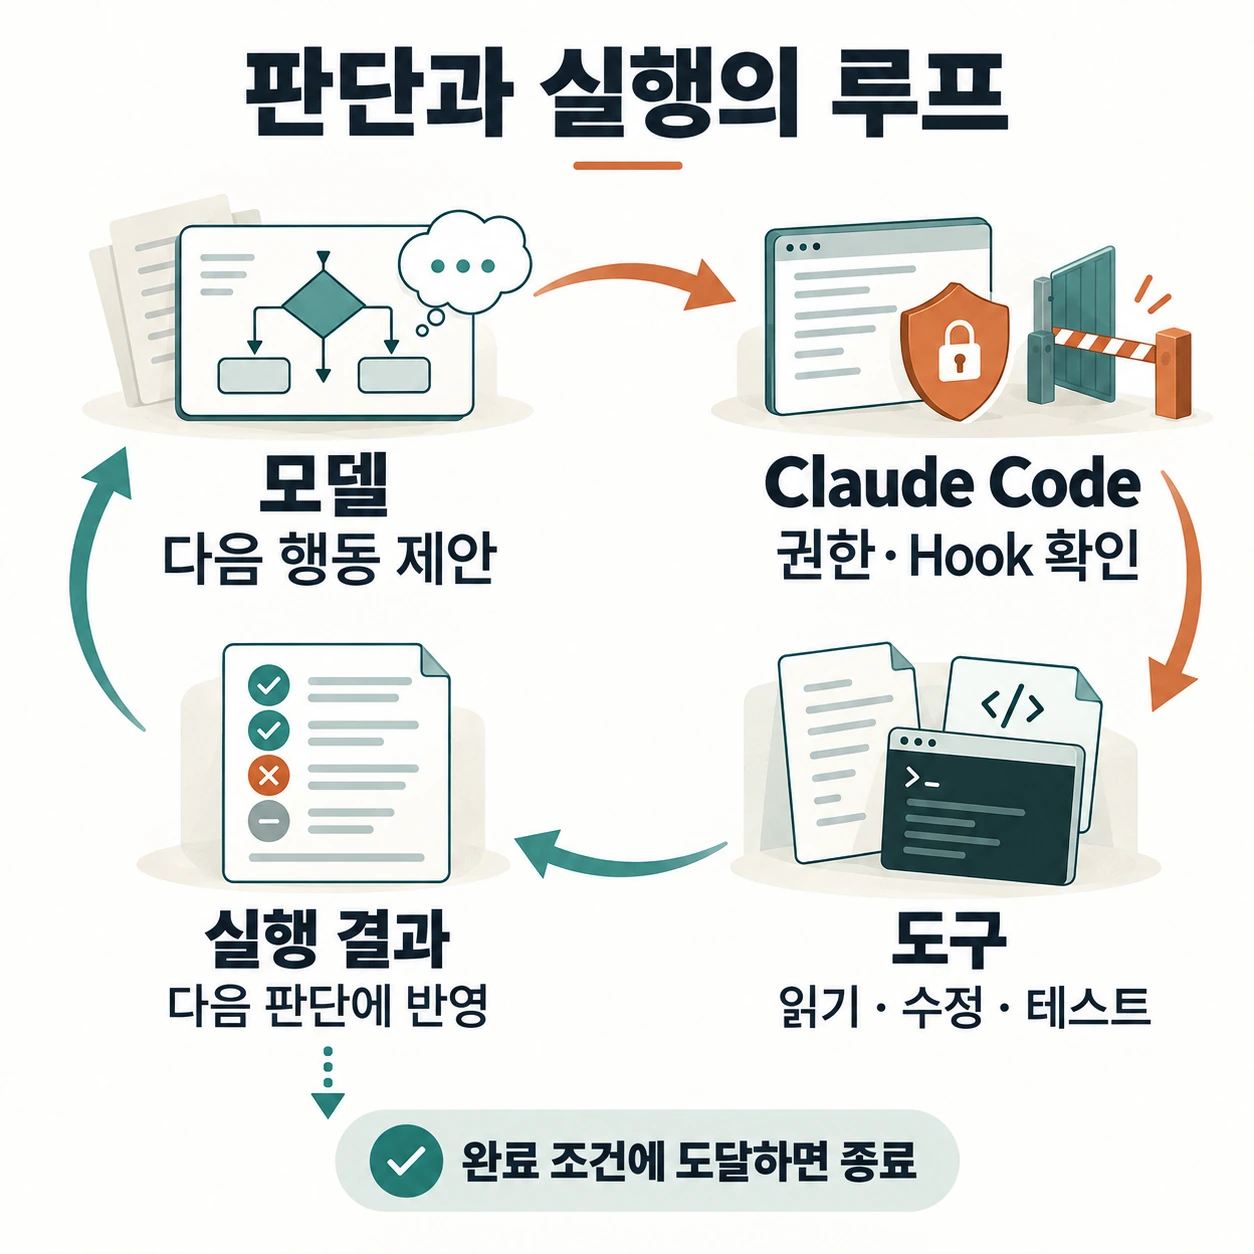
이 구분을 알면 실패 원인을 좁힐 수 있습니다. 필요한 파일을 읽지 못했다면 입력과 도구 접근을 확인하고, 같은 검사를 빠뜨린다면 검사 시점을 실행 환경에 연결합니다. 결과를 판단할 기준이 없다면 성공 조건을 보충합니다. 모델을 바꾸기 전에 어느 단계에서 정보나 통제가 빠졌는지 살펴볼 수 있습니다. 현재 공식 문서: Claude Code 작동 방식
강좌는 모델 선택과 추론 강도도 함께 다룹니다. 녹화 당시의 모델별 추천은 당시 사용 경험으로 읽어야 합니다. 현재 허용되는 추론 강도는 모델에 따라 다르므로 공식 모델 설정을 확인해야 합니다. 실무에서는 같은 작업으로 정확도, 완료 시간, 재시도 횟수와 총비용을 비교할 수 있습니다. 낮은 단가의 모델이 여러 번 실패하면 작업 전체 비용은 커질 수 있습니다.
CLAUDE.md와 Plan mode: 수정 전에 기준 맞추기
CLAUDE.md에는 프로젝트에서 계속 참고할 규칙을 적습니다. 개발·테스트 명령, 중요한 디렉터리, 유지해야 할 API 형식처럼 실제 판단에 영향을 주는 정보가 적합합니다. 강좌는 /init으로 초안을 만들고 필요한 지침을 다듬는 흐름을 보여줍니다. 이미 코드에서 쉽게 찾을 수 있는 설명과 오래된 규칙은 줄여야 컨텍스트를 효율적으로 쓸 수 있습니다. 원 강좌의 설정 과정 · 현재 지침·메모리 문서
예를 들어 “기존 API와 호환되게 작성”에 “성공 응답 필드와 오류 형식을 유지하고 계약 테스트로 확인”을 더하면 검토할 대상과 방법이 생깁니다. 이번 버그의 임시 설명은 작업 요청에 두고, 다음 작업에서도 필요한 규칙만 CLAUDE.md에 남기는 편이 관리하기 쉽습니다.
Plan mode에서는 조사 결과와 변경 계획을 먼저 검토합니다. 강좌의 화면 구현 시연은 참고 이미지를 제공해 기대 결과를 구체화합니다. 코드 작업에서도 재현 절차와 테스트를 함께 주면 완료 여부를 판단하기 쉬워집니다. 다음은 이 글에서 구성한 버그 조사 요청 예시입니다.
검색 결과에서 다음 페이지를 누르면 필터가 사라진다.
Plan mode에서 관련 코드를 조사해줘.

1. 필터 값이 전달되는 경로와 근거 파일
2. 원인 후보, 확인한 사실과 아직 검증하지 못한 가정
3. 수정할 파일과 유지해야 할 기존 동작
4. 수정 전 재현 방법과 수정 후 통과 기준

계획을 검토할 수 있게 정리해줘.
계획은 원인 후보가 코드에 연결돼 있는지, 제안한 검사가 증상을 실제로 잡는지 확인하면 됩니다. 범위가 분명한 오탈자 수정에는 긴 계획이 필요하지 않습니다.
Skills와 Hooks: 강좌의 이슈 관리 예제로 이해하기
강좌 후반의 Plugin 실습에는 기능 선택에 도움이 되는 상황이 나옵니다. 팀에서 타입 검사를 빠뜨린 코드가 커밋되고, 완료한 이슈의 상태 변경과 담당자 해제도 자꾸 누락됩니다. 강사는 앞의 검사에는 Hook을, 뒤의 반복 절차에는 Skill을 연결합니다.
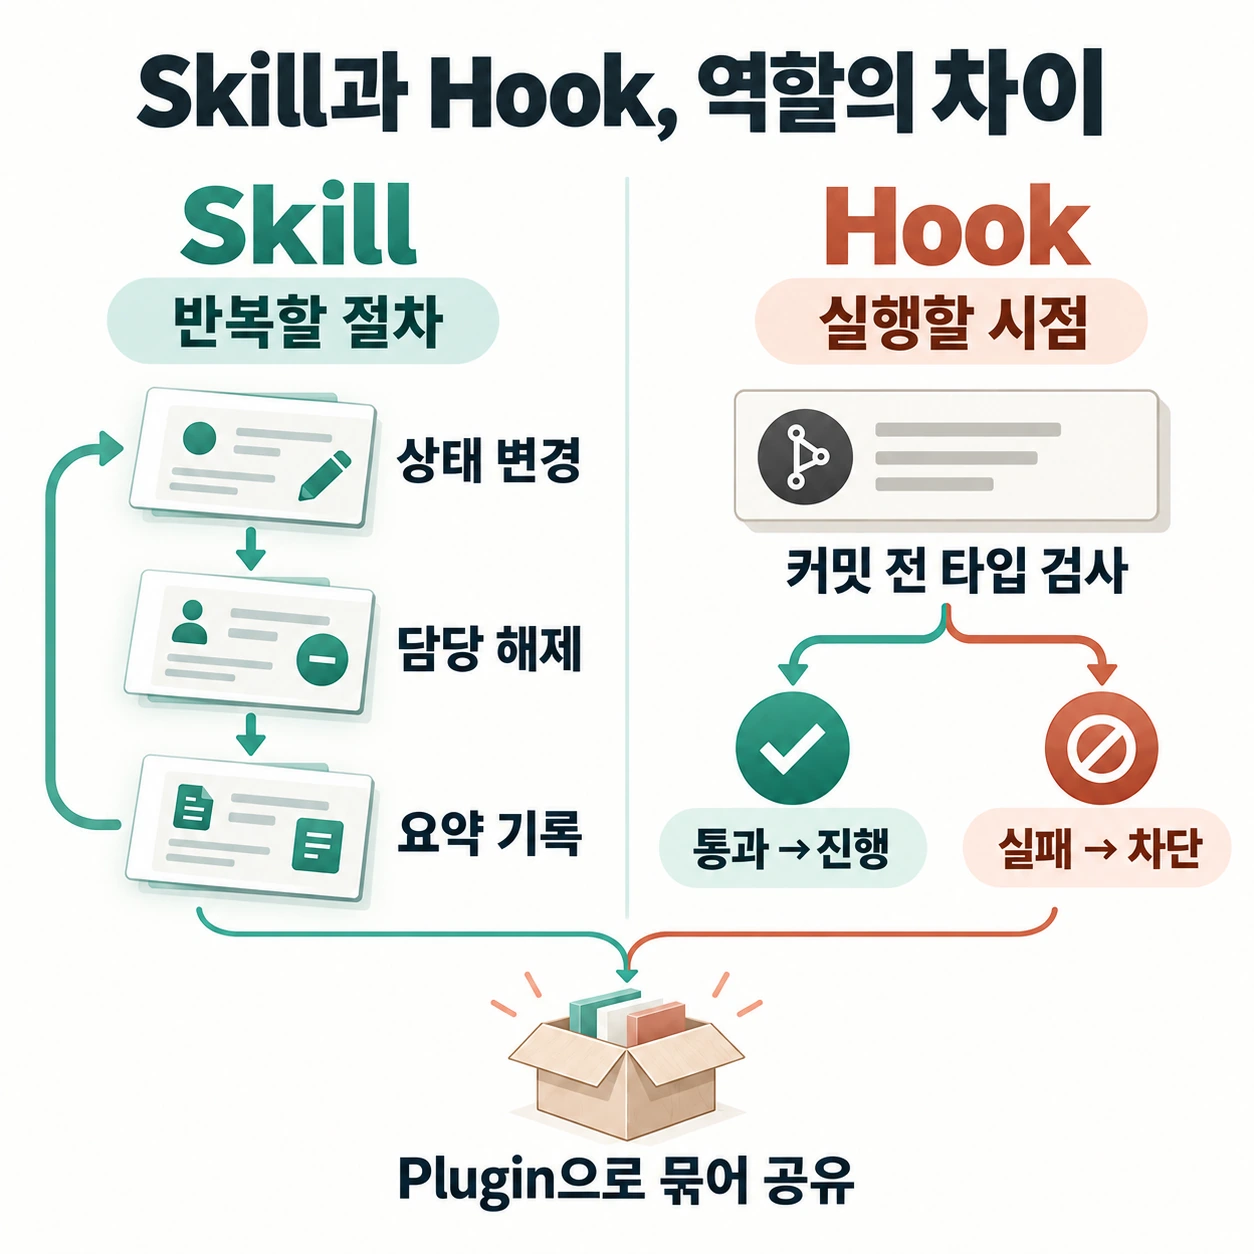
Skill은 반복할 작업 지침을 묶습니다. 프로젝트의 .claude/skills/ 아래에 작업별 디렉터리와 SKILL.md를 둡니다. 기본적으로 설명을 보고 필요한 Skill을 선택하며, 전체 지침은 호출할 때 컨텍스트에 들어옵니다. 강좌의 이슈 마무리 Skill은 상태를 완료로 바꾸고, 담당자를 해제하고, 한 줄 요약을 남기는 절차를 담습니다. 원 강좌: Skills
사용자가 직접 호출할 절차에는 아래처럼 disable-model-invocation: true를 지정할 수 있습니다. .claude/skills/review-change/SKILL.md로 저장하면 /review-change로 요청합니다. 다음 코드는 이 글의 리뷰 예시입니다. 호출 제어 공식 문서
---
name: review-change
description: 변경 내용을 읽고 재현 가능한 결함을 검토한다.
disable-model-invocation: true
---

1. 현재 변경과 관련 코드를 읽는다.
2. 기존 동작과 달라진 부분을 확인한다.
3. 문제마다 파일 위치, 발생 조건, 영향을 적는다.
4. 직접 확인한 사실과 추측을 구분한다.
5. 파일을 수정하지 않고 검토 결과를 보고한다.
Hook은 정해진 이벤트에 동작을 연결합니다. 강좌의 커밋 검사처럼 실행을 막아야 하는 검사는 PreToolUse에서 도구 호출 내용을 확인하고 실패 시 차단하도록 구성합니다. PostToolUse는 도구 실행이 끝난 뒤이므로 이미 수행한 커밋을 사전에 막을 수 없습니다. 파일 편집 뒤 포맷 확인처럼 사후 처리가 필요한 곳에 적용할 수 있습니다. Hooks 공식 문서
Hook 스크립트도 검사 범위와 명령 판별을 제대로 구현해야 합니다. 모든 편집에 전체 테스트를 연결하면 작은 수정도 오래 걸립니다. 변경 파일의 빠른 검사와 작업 완료 시 전체 검사를 나누면 실행 비용을 조절할 수 있습니다.
원 강좌의 Skill Creator 수업은 Skill을 만든 뒤 평가하는 흐름도 보여줍니다. 도입 효과를 확인하려면 같은 입력으로 Skill을 사용한 결과와 사용하지 않은 결과를 비교해야 합니다. 예를 들어 리뷰용 Skill에는 “실제 결함이 있는 변경”, “문제가 없는 변경”, “판단에 필요한 정보가 부족한 변경”을 준비할 수 있습니다. 결함 발견, 오탐, 근거의 정확성, 시간·비용을 함께 기록하세요. 이 세 가지 평가 입력은 본문에서 제안하는 적용 예시입니다.
Plugin은 이런 설정을 팀에 전달하는 묶음입니다. 강좌에서는 Skill과 Hook을 패키지에 넣고, Agents와 MCP도 함께 배포할 수 있다고 설명합니다. MCP는 외부 데이터와 도구를 연결하는 데 사용하고, Agent SDK는 Claude Code의 실행 기능을 프로그램에서 활용할 때 검토합니다. 반복 절차를 공유하려는지, 외부 시스템을 연결하려는지, 별도 프로그램을 만들려는지에 따라 도입 대상이 달라집니다. MCP 수업 · Agent SDK 수업
Subagents와 Agent teams: 조사 범위부터 나누기
Subagent는 별도의 컨텍스트에서 한정된 일을 수행합니다. 강좌는 코드 리뷰를 보조 에이전트에 맡겨 조사 중 읽은 파일과 도구 출력이 주 대화에 계속 쌓이는 것을 줄입니다. 주 대화는 반환된 결과를 받아 다음 작업을 이어갑니다. 아래는 일반적인 조사 위임을 도식화한 것입니다. 원 강좌의 리뷰 시연
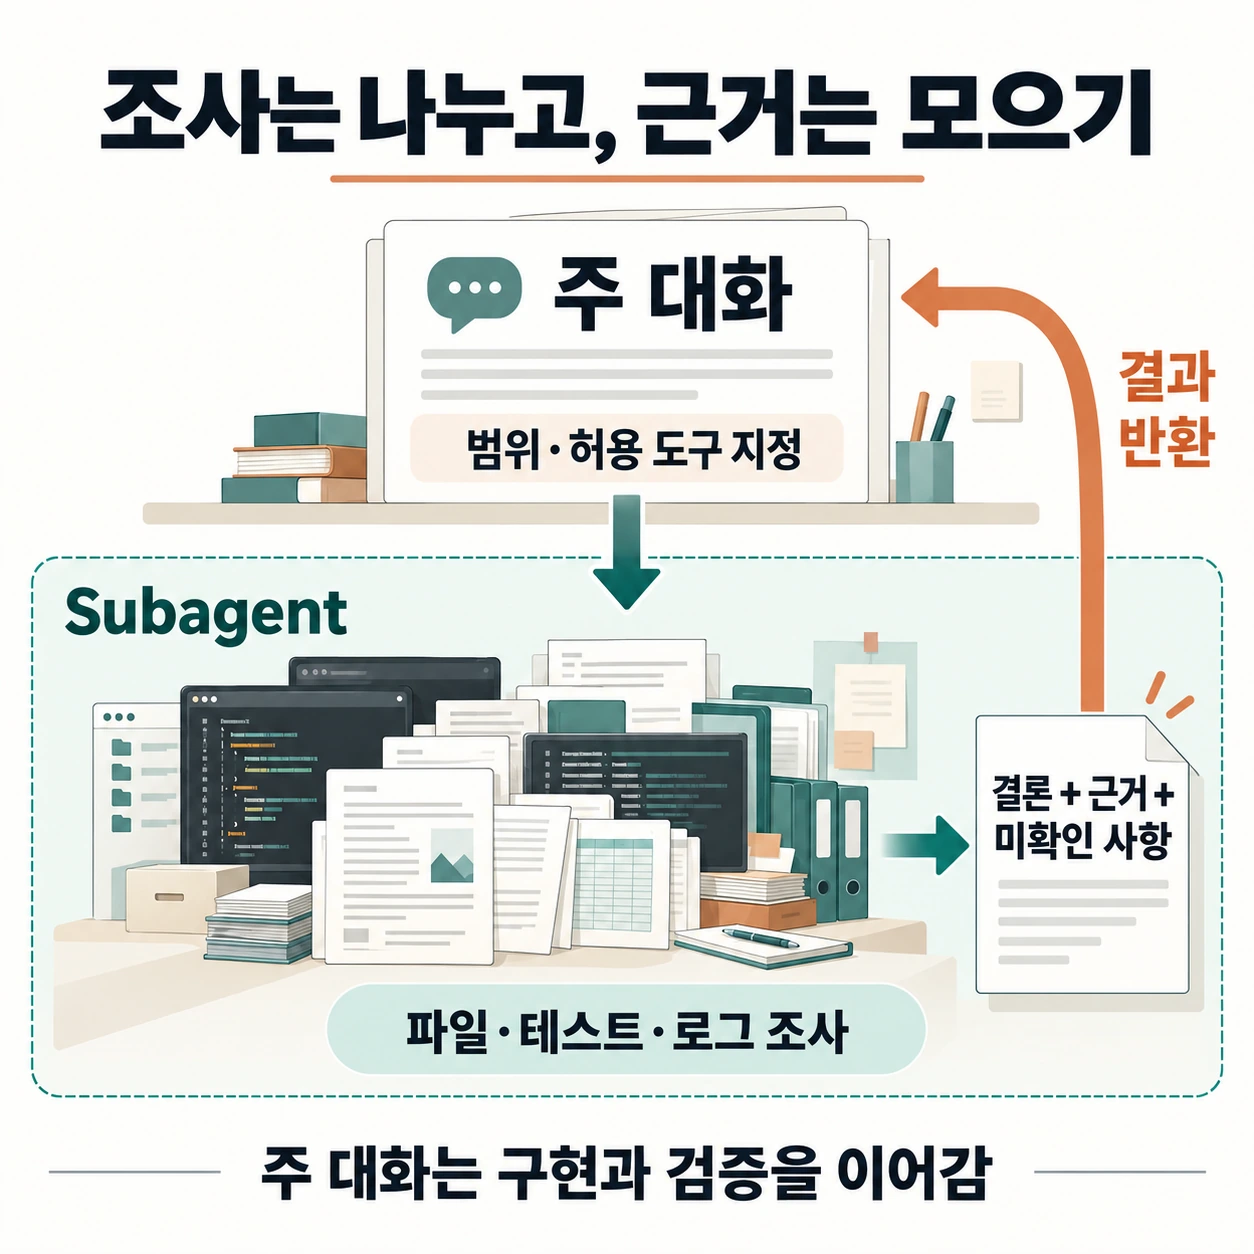
검색 필터 버그라면 주 작업은 필터 값의 전달 경로를 조사하고, 보조 에이전트는 관련 테스트와 빠진 조건을 찾도록 나눌 수 있습니다. 위임할 때 입력과 범위, 허용 행동, 반환 형식을 함께 지정하세요. “테스트 조사”보다 “관련 파일을 읽고 다루는 조건·빠진 조건·근거 위치를 보고”가 결과를 검토하기 쉽습니다.
별도 컨텍스트를 쓰면 주 대화에 들어오는 정보를 줄일 수 있지만, 보조 에이전트도 모델을 호출하므로 추가 비용이 발생합니다. 서로 같은 파일을 수정하거나 상대 결과를 계속 기다려야 한다면 분리의 이점이 작아집니다. 독립적으로 끝낼 수 있는 조사부터 나누는 편이 좋습니다.
Agent teams는 여러 세션이 메시지와 작업 목록으로 협업하는 방식입니다. 관점별 검토와 상호 토론이 필요한 경우에 고려할 수 있습니다. 현재는 이름이 붙은 Subagent도 메시지를 보낼 수 있으므로, 통신 가능 여부만으로 두 기능을 구분하면 부족합니다. 작업 조율 방식과 독립 세션 운영이 필요한지 함께 판단해야 합니다. 공식 비교표
검증 루프와 자기 개선은 어떻게 적용할까
이 절은 원 강좌와 별도로 덧붙인 확장 설명입니다. 강좌에서 다루는 도구 호출 루프를 실제 작업에 적용하려면 성공 조건과 종료 조건이 필요합니다. 검색 필터 버그의 경우 “재현 → 조사 → 수정 → 검사”를 기본 경로로 두고, 실패하면 관찰된 결과와 함께 수정 단계로 돌아갈 수 있습니다. 통과하면 종료하고, 같은 실패가 반복되거나 정보가 부족하면 판단을 요청합니다.
이런 단계와 분기, 되돌아가는 경로를 표현하면 작업 그래프가 됩니다. 그래프를 그리는 것만으로 결과가 개선되지는 않습니다. Anthropic의 Building effective agents는 생성과 평가를 반복하는 evaluator-optimizer 패턴을 소개하며, 평가 기준이 명확하고 반복에 따른 개선을 측정할 수 있을 때 적합하다고 설명합니다.
버그 수정에서는 재현 조건과 관련 회귀 테스트의 통과 여부를 확인합니다. 다른 에이전트의 리뷰를 추가할 수 있지만, 실제 실행 여부와 결과도 함께 남겨야 합니다. 재시도는 작업의 비용과 소요 시간에 맞게 제한하고, 멈췄을 때는 원인 후보와 이미 시도한 내용을 전달해야 사람이 이어서 판단할 수 있습니다.
다음 작업까지 개선하려면 피드백을 지침에 반영하는 절차가 필요합니다. 공개된 Warp 사례에서는 별도의 개선 Skill이 사람의 피드백을 검토해 기본 Skill의 작은 변경을 제안합니다. PR 검토와 승인 후 다음 작업에 적용합니다. 갱신 대상은 Skill에 담긴 지침이며, 모델 가중치를 재학습하는 과정은 포함하지 않습니다.
리뷰가 사소한 이름 변경에만 집중한다면 “사용자가 겪을 오류와 재현 근거부터 보고”하도록 지침을 조정할 수 있습니다. 수정 전후를 같은 사례에 적용해 필요한 결함을 놓치지 않는지도 비교해야 합니다. 한 번 받은 피드백이 모든 작업에 유효한지 확인하는 과정이 여기에 들어갑니다.
작은 작업 하나로 도입 효과 확인하기
다음은 이 글에서 구성한 적용 순서입니다. 앞서 든 검색 필터 버그 하나로 시작해 각 단계에서 확인할 결과물을 남깁니다.
- 성공 조건: 다음 페이지에서도 필터가 유지되고, 필터 변경·해제도 기존대로 동작해야 합니다. 수정 전 재현 절차를 기록합니다.
- 공통 지침: CLAUDE.md에 실제 테스트 명령과 유지할 API 형식을 적습니다. 이번 버그 설명은 작업 요청에 둡니다.
- 계획 검토: Plan mode에서 원인, 근거 파일, 변경 범위와 검사 방법을 확인합니다. 조사량이 클 때만 독립된 범위를 Subagent에 맡깁니다.
- 수정과 검증: 재현 조건과 관련 회귀 테스트를 검사합니다. 예를 들어 같은 실패에 대한 재시도는 두 번까지로 정하고, 계속 실패하면 시도한 내용과 필요한 판단을 보고하도록 합니다.
- 반복 절차 정리: 같은 리뷰를 자주 요청하면 Skill로 옮기고, 빠뜨리는 검사에는 Hook을 검토합니다. 작업 시간, 재시도, 사람이 발견한 오류를 이전 작업과 비교합니다.
두 번이라는 횟수는 이 예시의 운영 기준입니다. 실제로는 작업 비용과 실패의 성격에 맞게 정하면 됩니다. 작업용 서버나 보조 프로세스를 실행했다면 자신이 시작한 자원의 종료 여부도 완료 보고에 포함할 수 있습니다.
직접 실습하려면 강사의 이슈 트래커 예제 저장소와 전체 원 강좌를 함께 참고하세요. 명령을 따라 하기 전 claude --version으로 설치 버전을 확인하고, 설정은 이 글의 비교표에 연결한 공식 레퍼런스를 기준으로 적용하면 됩니다.