CONTINUITY STUDY 01 → 03
인물 장소 소품
장면이 바뀌어도 이어지는 세계의 기억.AI 생성 일러스트 · 개념적 비유
01 / THE CHALLENGE
길어질수록, 잘 그리는 것만으로는 부족하다
외형이 달라진다 앞 장면의 의상과 공간이 다음 장면에서 의도 없이 바뀝니다.
오류가 이어진다 처음의 잘못된 시각 자료가 뒤의 영상 생성까지 영향을 줍니다.
원인을 놓친다 완성본의 문제를 어느 단계의 프롬프트가 만들었는지 찾기 어렵습니다.
이야기가 멈춘다 화면은 계속되지만 의미 있는 사건은 진전되지 않을 수 있습니다.
핵심 관점 긴 영상의 품질은 창작 방향을 고르고, 에 달려 있습니다.
원문을 바탕으로 한 편집적 해석 Gemini·Veo 같은 기반 모델 위에서 제작을 조율하는 연구입니다. 네 연구는 서로 보완하는 접근이며, 아래 순서가 모두를 직렬 연결한 단일 제품을 뜻하지는 않습니다.
02 / CO-DIRECTOR
방향은 함께 정하고, 결과로 다시 고친다
감독 역할의 에이전트가 의도·이야기 구조·화면 분위기 를 선택합니다. 이 방향을 모든 제작 단계에 전달하고, 완성 영상을 평가해 다음 선택에 반영합니다.
창작 전략 무엇을 전할까? 서사 방식 어떻게 이야기할까? 미학적 유형 어떤 분위기일까?
01 방향 선택 새로운 시도와 02 사전 제작 줄거리·시각 자료 03 제작 키프레임·영상 04 완성본 평가 영상과 언어를 ↶ 평가 결과를 차원별 보상으로 나눠, 다음 창작 방향 선택에 반영
전체 방향을 탐색하는 순환과 각 단계의 자체 개선을 함께 사용합니다. 용어 풀기 · 다중 슬롯머신 문제(MAB) 아직 시도하지 않은 방향을 탐색할지, 이미 좋은 결과를 낸 방향을 활용할지 선택하는 문제입니다. 여기서는 창작 방향을 고르는 데 사용합니다. Co-Director 논문 ↗
03 / CANVAS
다시 돌아온 방은, 같은 방이어야 한다
CANVAS는 스토리보드부터 장면 간 연결을 계획합니다. 인물·장소·소품 상태 를 구조화해 기억하고, 필요한 시각 기준을 꺼내 쓰거나 새로 만듭니다.
장면 A · 첫 등장 박물관 전시실 인물의 모자
지속적인 시각적 기억 인물 정체성·외형장소 공간 구조·기준 이미지소품 형태·이야기 속 상태저장 → 다른 장면 → 검색 장면 C · 재방문 같은 전시실 같은 인물인가?
원문의 박물관 사례를 단순화한 관계도. 바로 이어지는 컷뿐 아니라, 다른 곳을 거쳐 돌아온 장면도 기억과 연결합니다. 박물관 비교 사례에서는 기준 모델의 소품·배경 변화, 다른 에이전트 방식의 모자 누락 등을 보여줍니다. 일관성은 모든 상태를 고정한다는 뜻이 아니라 이야기 속 변화도 추적한다는 뜻입니다. CANVAS 논문 ↗
04 / A²RD
기억을 붙잡되, 이야기를 멈추지 않는다
A²RD는 긴 영상을 구간별로 순차 생성합니다. 앞선 구간의 맥락과 움직임을 멀티모달 영상 기억으로 추적하고, 프레임과 영상 수준에서 스스로 개선해 오류 전파를 줄입니다.
01 기억 검색 02 구간 생성 03 오류 개선 04 기억 갱신 ↶ 다음 구간에서도 검색 → 생성 → 개선 → 갱신 반복
이미지와 영상 등 여러 형식의 기억을 참조해, 새 구간을 앞선 이야기와 연결합니다. → 외삽 · 다음 사건으로 지금까지의 맥락을 바탕으로 새로운 전개를 생성합니다.
↔ 보간 · 기존 기준과 연결 기존 인물과 환경의 시각 기준에 구간을 연결합니다.
상황에 맞게 두 방식을 전환합니다. 원문은 10분짜리 시연 영상을 소개하지만, 임의의 길이에서 완전한 일관성을 보장한다는 뜻은 아닙니다. A²RD 논문 ↗
05 / VQQA
마지막 결과보다, 원래 요청에 맞는 결과
“풍선의 재질과 모양이 맞는가?”, “연주자가 같은 악기를 연주하는가?” 요청에 맞춘 시각적 질문으로 오류를 찾고, 비평을 다음 프롬프트의 수정 방향으로 사용합니다.
01 영상 생성 요청에서 첫 후보 생성 02 질문과 평가 시각·언어 모델의 비평 03 프롬프트 수정 자연어로 수정 방향 반영 04 새 후보 생성 평가와 수정을 반복 후보 1 · 후보 2 · 후보 3 · … ↓ 수정하지 않은 원래 요청으로 전체 후보 평가 ↓ 가장 잘 맞는 후보 선택 · Global Selection
수정 과정의 마지막 결과를 자동 채택하지 않습니다. 부분적인 교정으로 전체 의도에서 벗어나는 현상을 줄입니다. 고치는 대상은 프롬프트입니다. 픽셀을 직접 덧칠하는 편집기가 아닙니다. 모델 내부에 접근하지 않고 입력을 바꿔 새 영상을 생성합니다. ‘의미적 기울기’는 자연어 피드백의 비유이며, 모델 가중치를 역전파로 학습한다는 뜻이 아닙니다. VQQA 논문 ↗
COMIC / 기억하는 감독
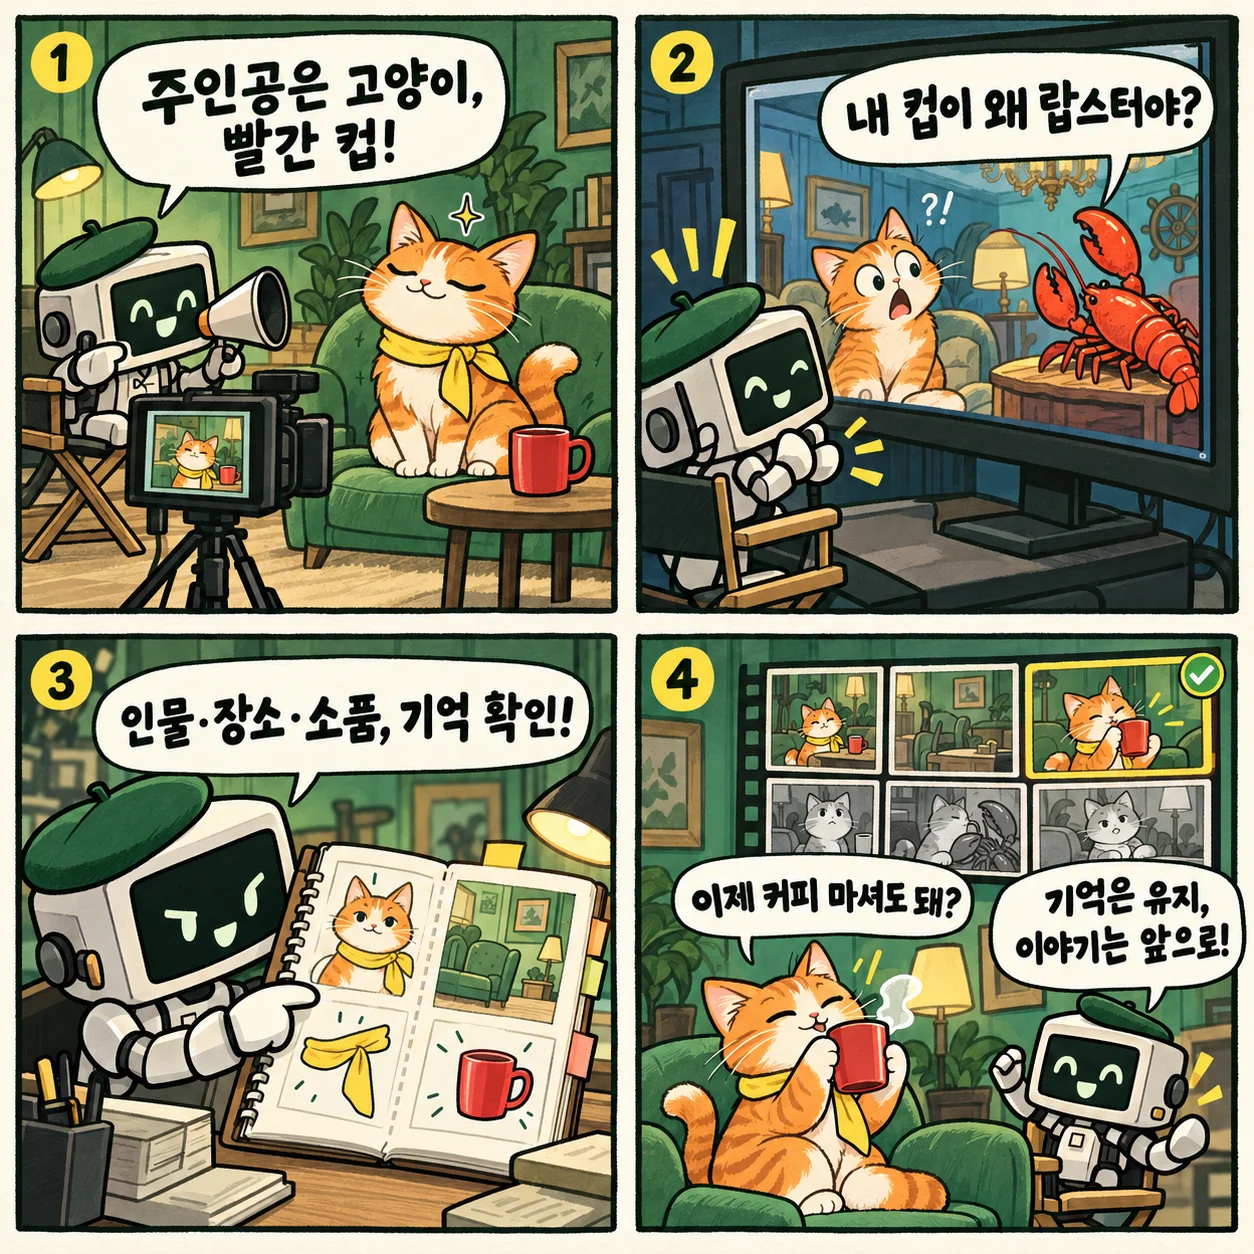
내 컵이 왜 랍스터야?
연구 개념을 설명하는 가상의 비유 · AI 생성 일러스트. 기억을 유지하는 목적은 장면을 얼리는 것이 아니라, 같은 세계에서 다음 사건을 이어가는 것입니다. 네 연구를 모두 연결한 실제 시스템이나 실험 결과를 묘사한 것은 아닙니다.
연구 개념을 설명하는 가상의 비유 · AI 생성 일러스트. 인물·장소·소품의 기억을 유지하며 다음 사건으로 나아갑니다. 여러 연구에서 착안한 비유이며 실제 시스템이나 실험 결과를 묘사하지 않습니다.
4컷 만화 원본 크게 보기 ↗
4컷 대본 읽기 · 왼쪽 위 → 오른쪽 위 → 왼쪽 아래 → 오른쪽 아래 촬영 시작. 노란 스카프를 한 고양이와 빨간 컵. 감독: “주인공은 고양이, 빨간 컵!”다음 장면의 사고. 스카프와 방이 달라지고 컵은 랍스터가 됩니다. 고양이: “내 컵이 왜 랍스터야?”기억 확인. 감독이 고양이·스카프·방·컵의 기준 그림을 참조합니다. “인물·장소·소품, 기억 확인!”의도에 맞는 후보 선택. 같은 고양이가 같은 방에서 빨간 컵으로 커피를 마십니다. 고양이: “이제 커피 마셔도 돼?” 감독: “기억은 유지, 이야기는 앞으로!”시각적 기억은 CANVAS, 기억을 유지하며 전개하는 관점은 A²RD, 원래 요청으로 후보를 고르는 관점은 VQQA에서 착안했습니다. VQQA는 픽셀을 덧칠하는 것이 아니라 프롬프트를 고쳐 새 후보를 생성합니다.
06 / THE EVIDENCE
성과는, 비교 조건과 함께 읽는다 아래는 연구 저자가 보고한 결과입니다. 연구마다 벤치마크와 지표가 다르므로 하나의 종합 순위로 비교할 수 없습니다.
CO-DIRECTOR / GENAD-BENCH 평균 평가 점수 기본형 · T=1 68.5
무작위 탐색 · T=4 75.7
Co-Director · T=4 81.4
+12.9점 / 상대 약 +18.8%
0~100점 척도 · 시각 자산 충실도, 대상 적합성, 마케팅 매력, 시각 품질 평가. 같은 T=4 무작위 탐색 대비로는 +5.7점입니다.
VQQA / 서로 다른 두 벤치마크 절대 개선폭 +11.57 %p T2V-CompBench
+8.43 %p VBench2
논문의 ‘absolute improvements (%)’를 퍼센트포인트(%p)로 표현했습니다. Co-Director의 상대 향상률 18.8%와는 다른 단위입니다. Gemini-3-Pro 평가 모델을 사용한 결과이며, 기본 생성 대비 개선폭입니다. VBench-I2V도 평가하지만 위 두 수치는 해당 벤치마크의 수치가 아닙니다.
네 연구의 역할·평가·해석 기준 연구 / 역할 평가 범위 보고된 성과 읽을 때의 기준 Co-Director 창작 의도 조율 GenAD-Bench 81.4/100 T=1과 T=4의 예산 차이. CANVAS 시각적 기억·스토리보드 ST-Bench · ViStoryBench · HardContinuityBench 배경 +21.6%논문 초록: 최상위 기준선 대비 보고값 논문 초록의 최상위 기준선 대비 보고값. 블로그는 최대 개선으로 표현. 모든 영상의 보장값이 아님. A²RD 구간별 생성·전개 VBench-Long · LVBench-C 등 일관성 최대 +30%논문 초록: 기존 방법 대비 최대 개선 최대 향상 수치. VQQA 질문 기반 개선·후보 선택 T2V-CompBench · VBench2 앞의 두 벤치마크에서 각각 절대 개선폭.
평가가 묻는 것 · 오래 떨어져 있어도 같은 대상인가? HardContinuityBench 는 긴 재등장 간격과 의상·액세서리·소품 상태 변화를 다룹니다. LVBench-C 는 120개 시나리오로 구성되며, 핵심 시각 요소가 최소 10개 구간 동안 사라졌다가 재등장합니다. 이처럼 바로 다음 컷을 넘어선 연속성도 평가합니다.
안전장치도 영상 전체의 맥락으로 기반 모델의 SynthID 등 보호 장치를 활용합니다. 제작 환경에서는 개별 클립을 합쳤을 때 생기는 맥락까지 살피는 추가 분류기를 적용할 수 있습니다.
남아 있는 질문 사람이 창작 방향을 통제하는 참여형 작업 흐름은 향후 과제입니다. 여기의 성과는 자체 재현 결과가 아니며, 제작 비용·속도·공개 서비스 이용 가능성은 추정하지 않습니다.